



Awlak Benjah
Suivi de diplôme et de moyenne hors ligne pour les étudiants de l'Université libanaise : une application Expo qui calcule sur le téléphone les moyennes pondérées par les crédits, la compensation et le verdict de réussite, avec une API NestJS pour les modèles, les sauvegardes et l'abonnement Shatour, et une console web pour l'administrer.
Aperçu de l'architecture
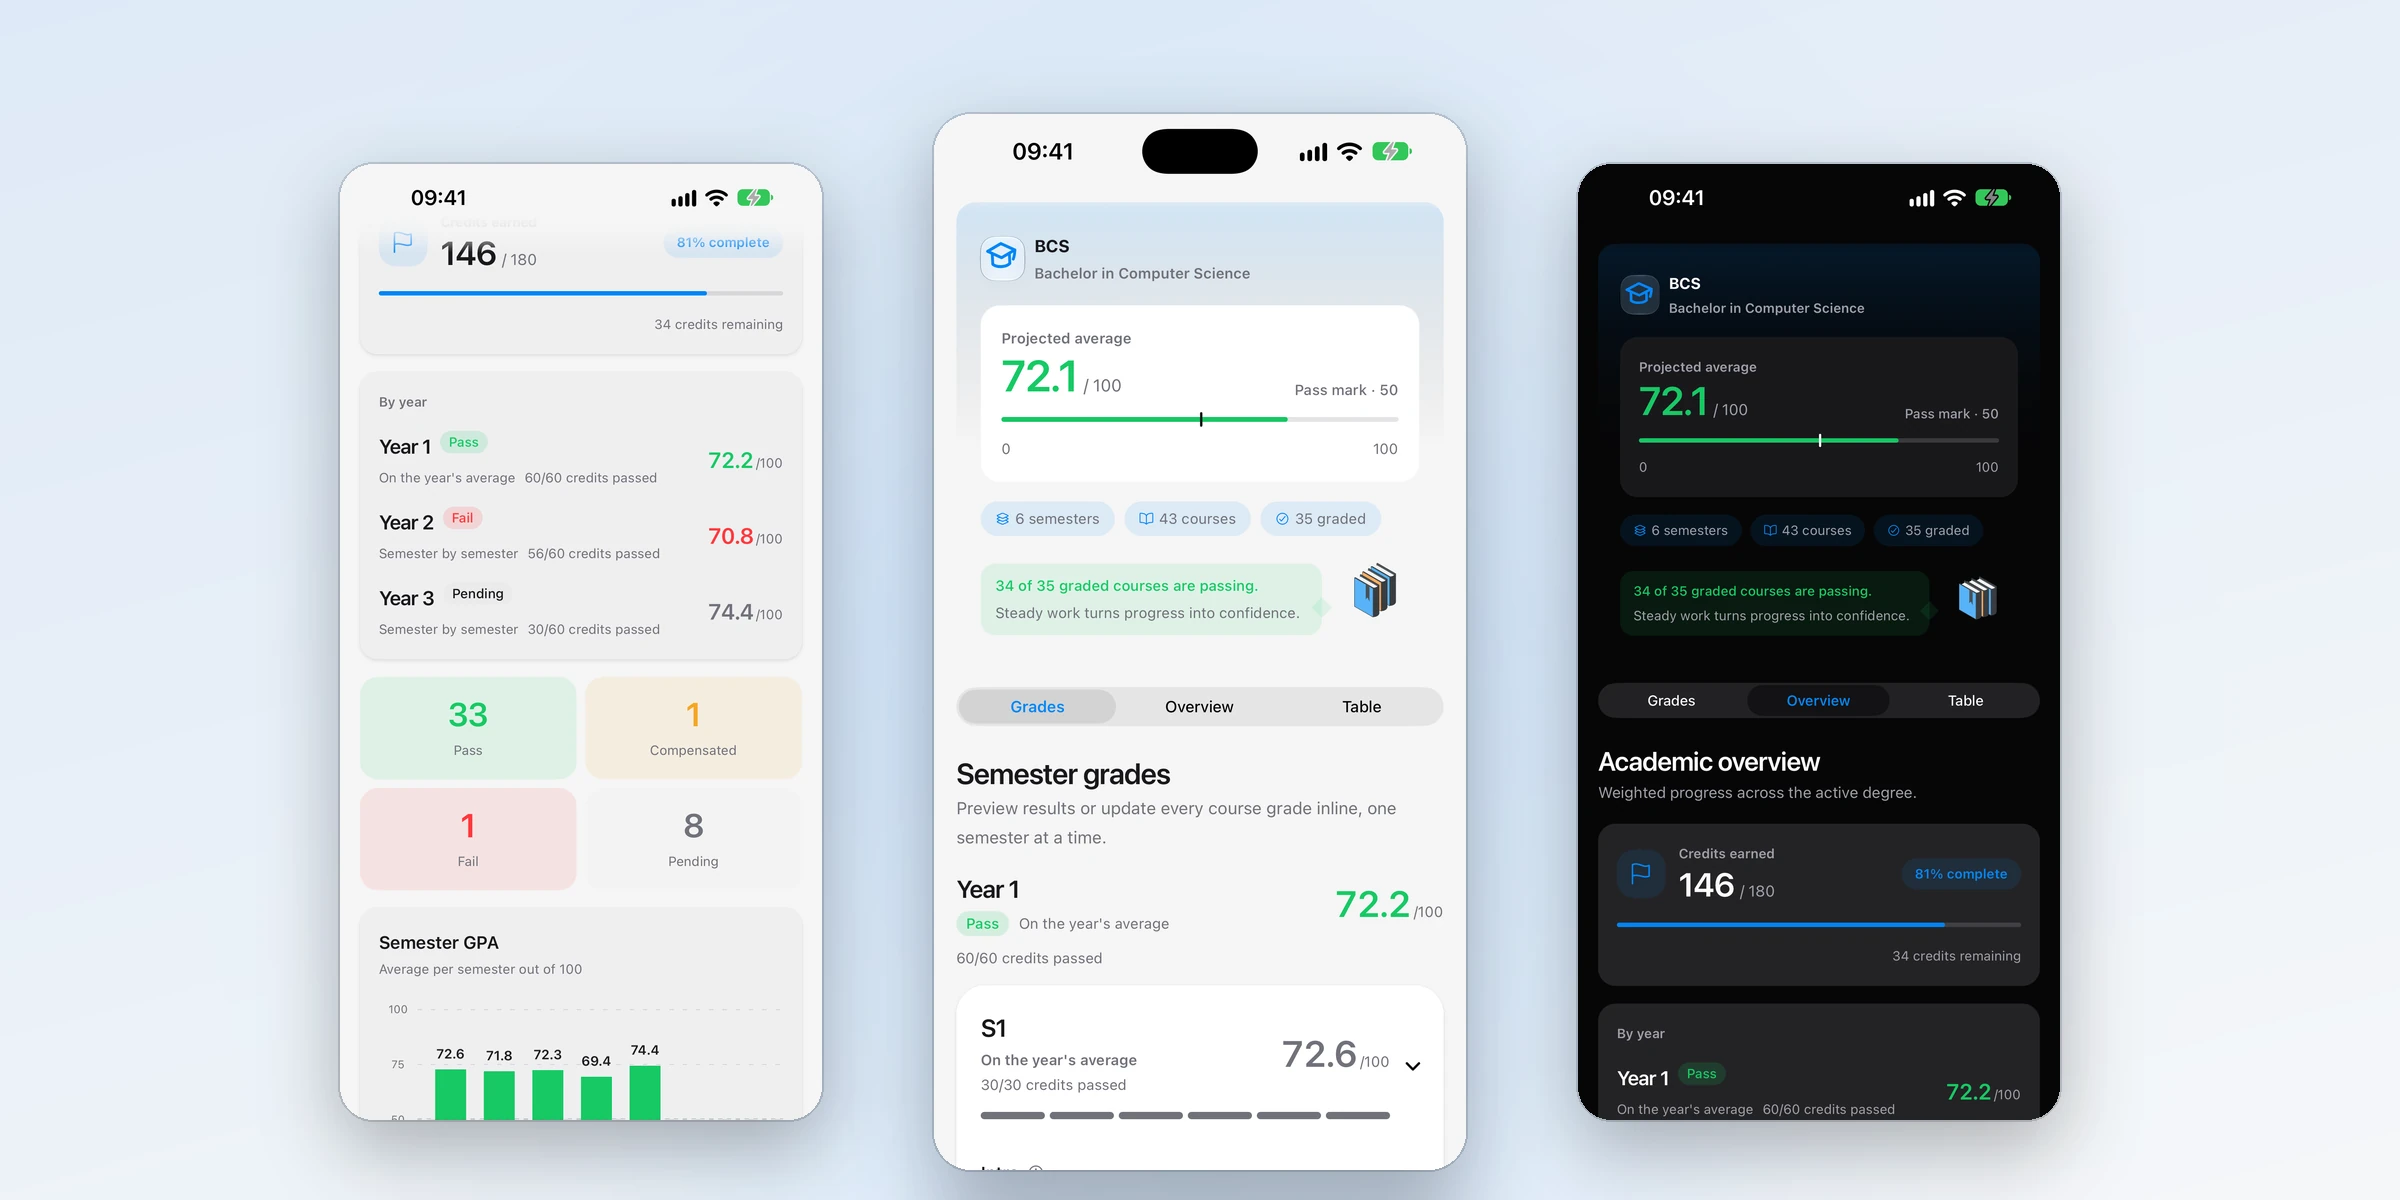
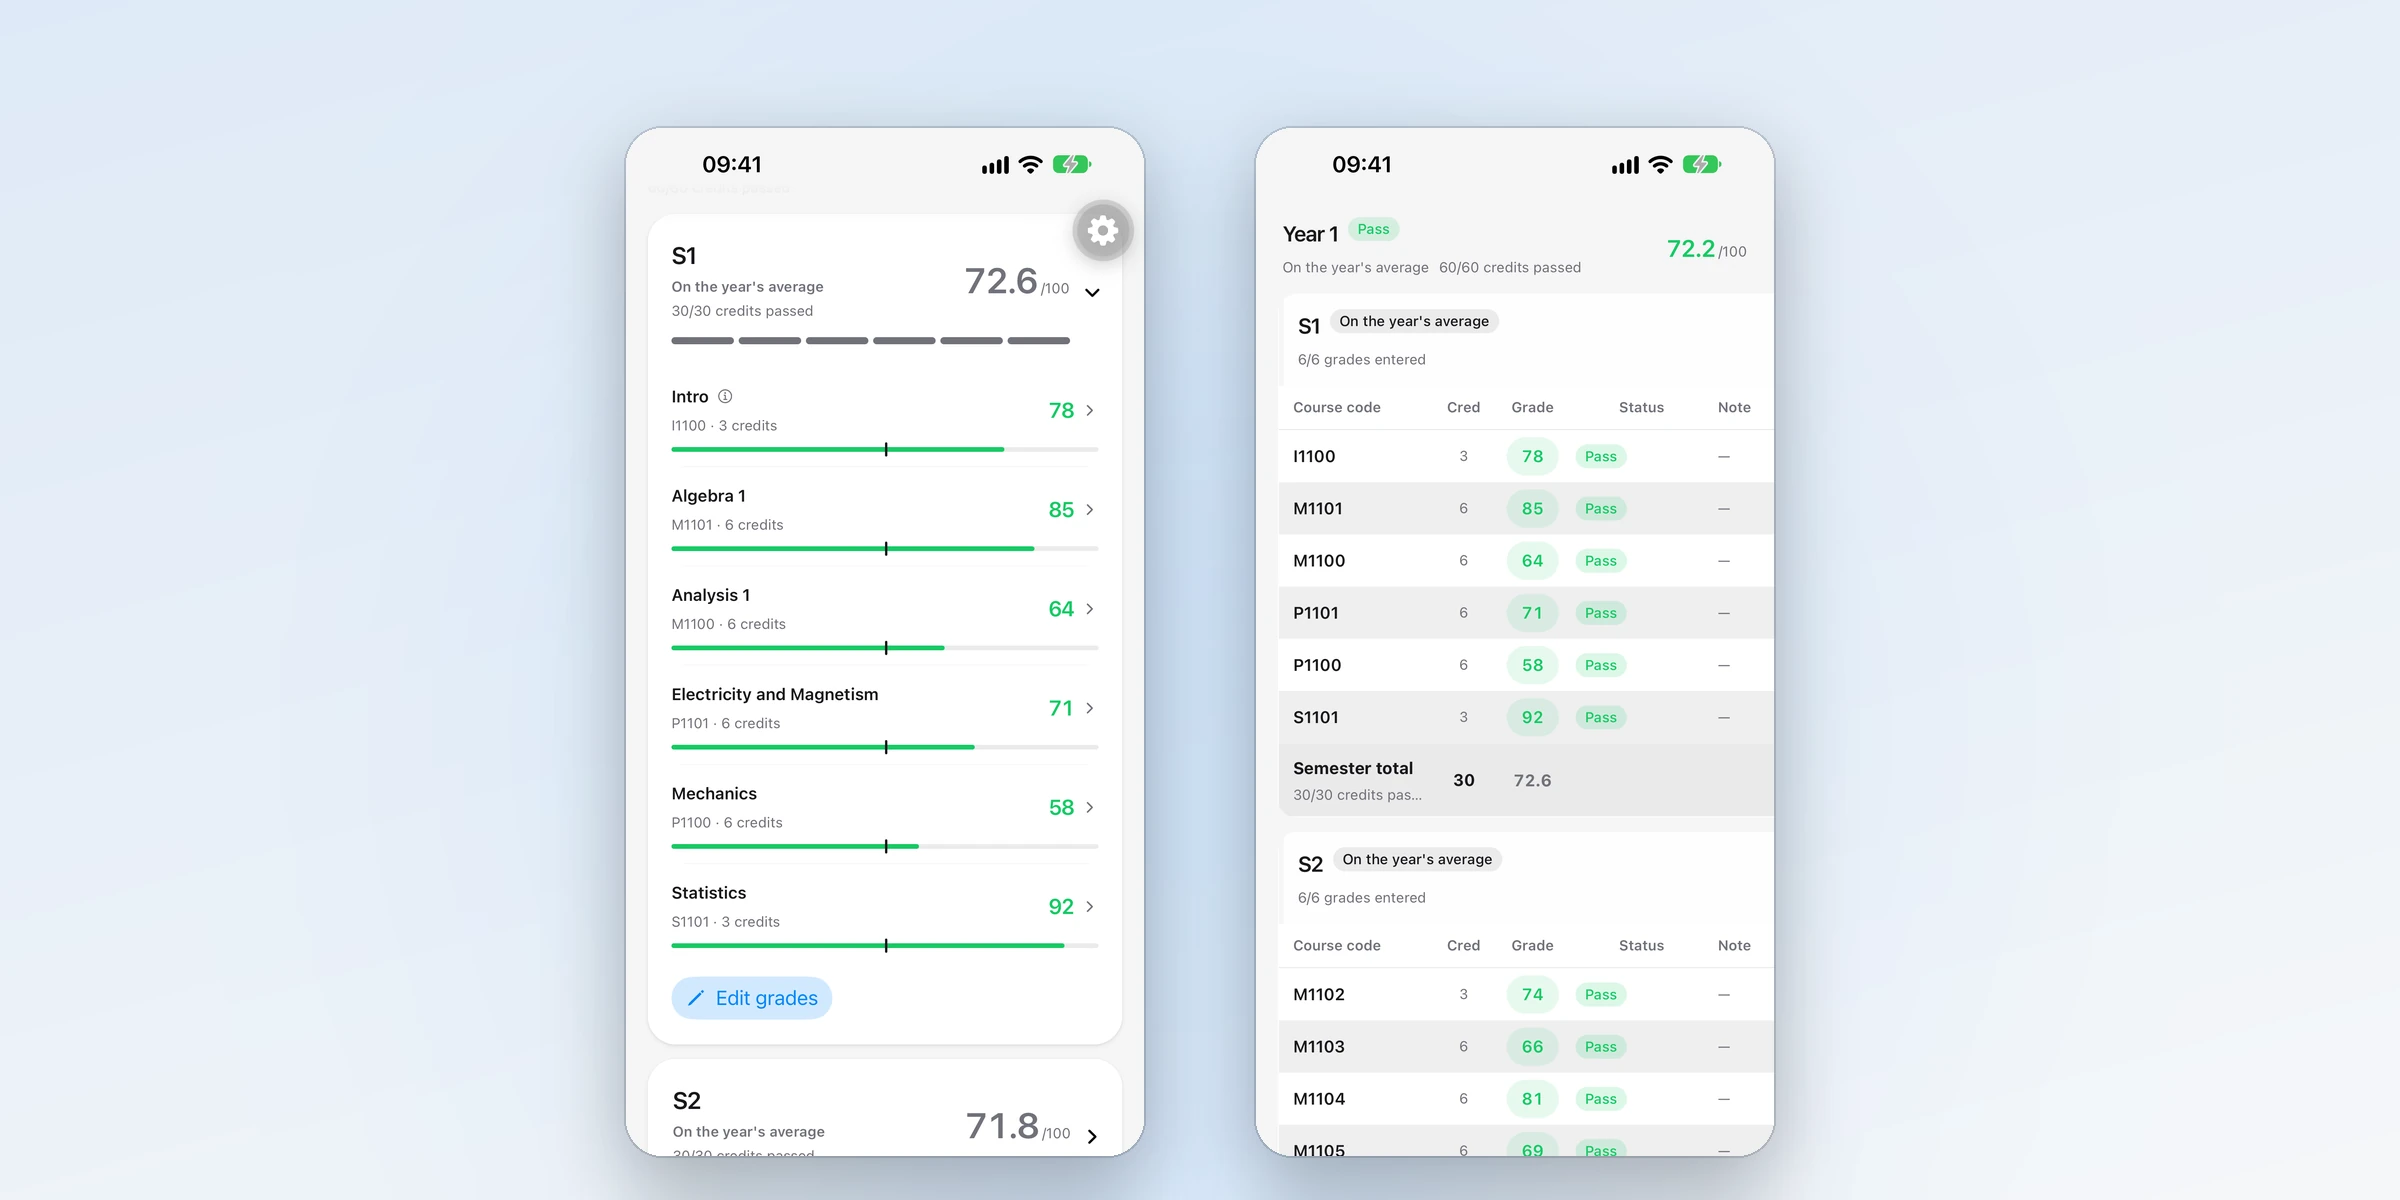
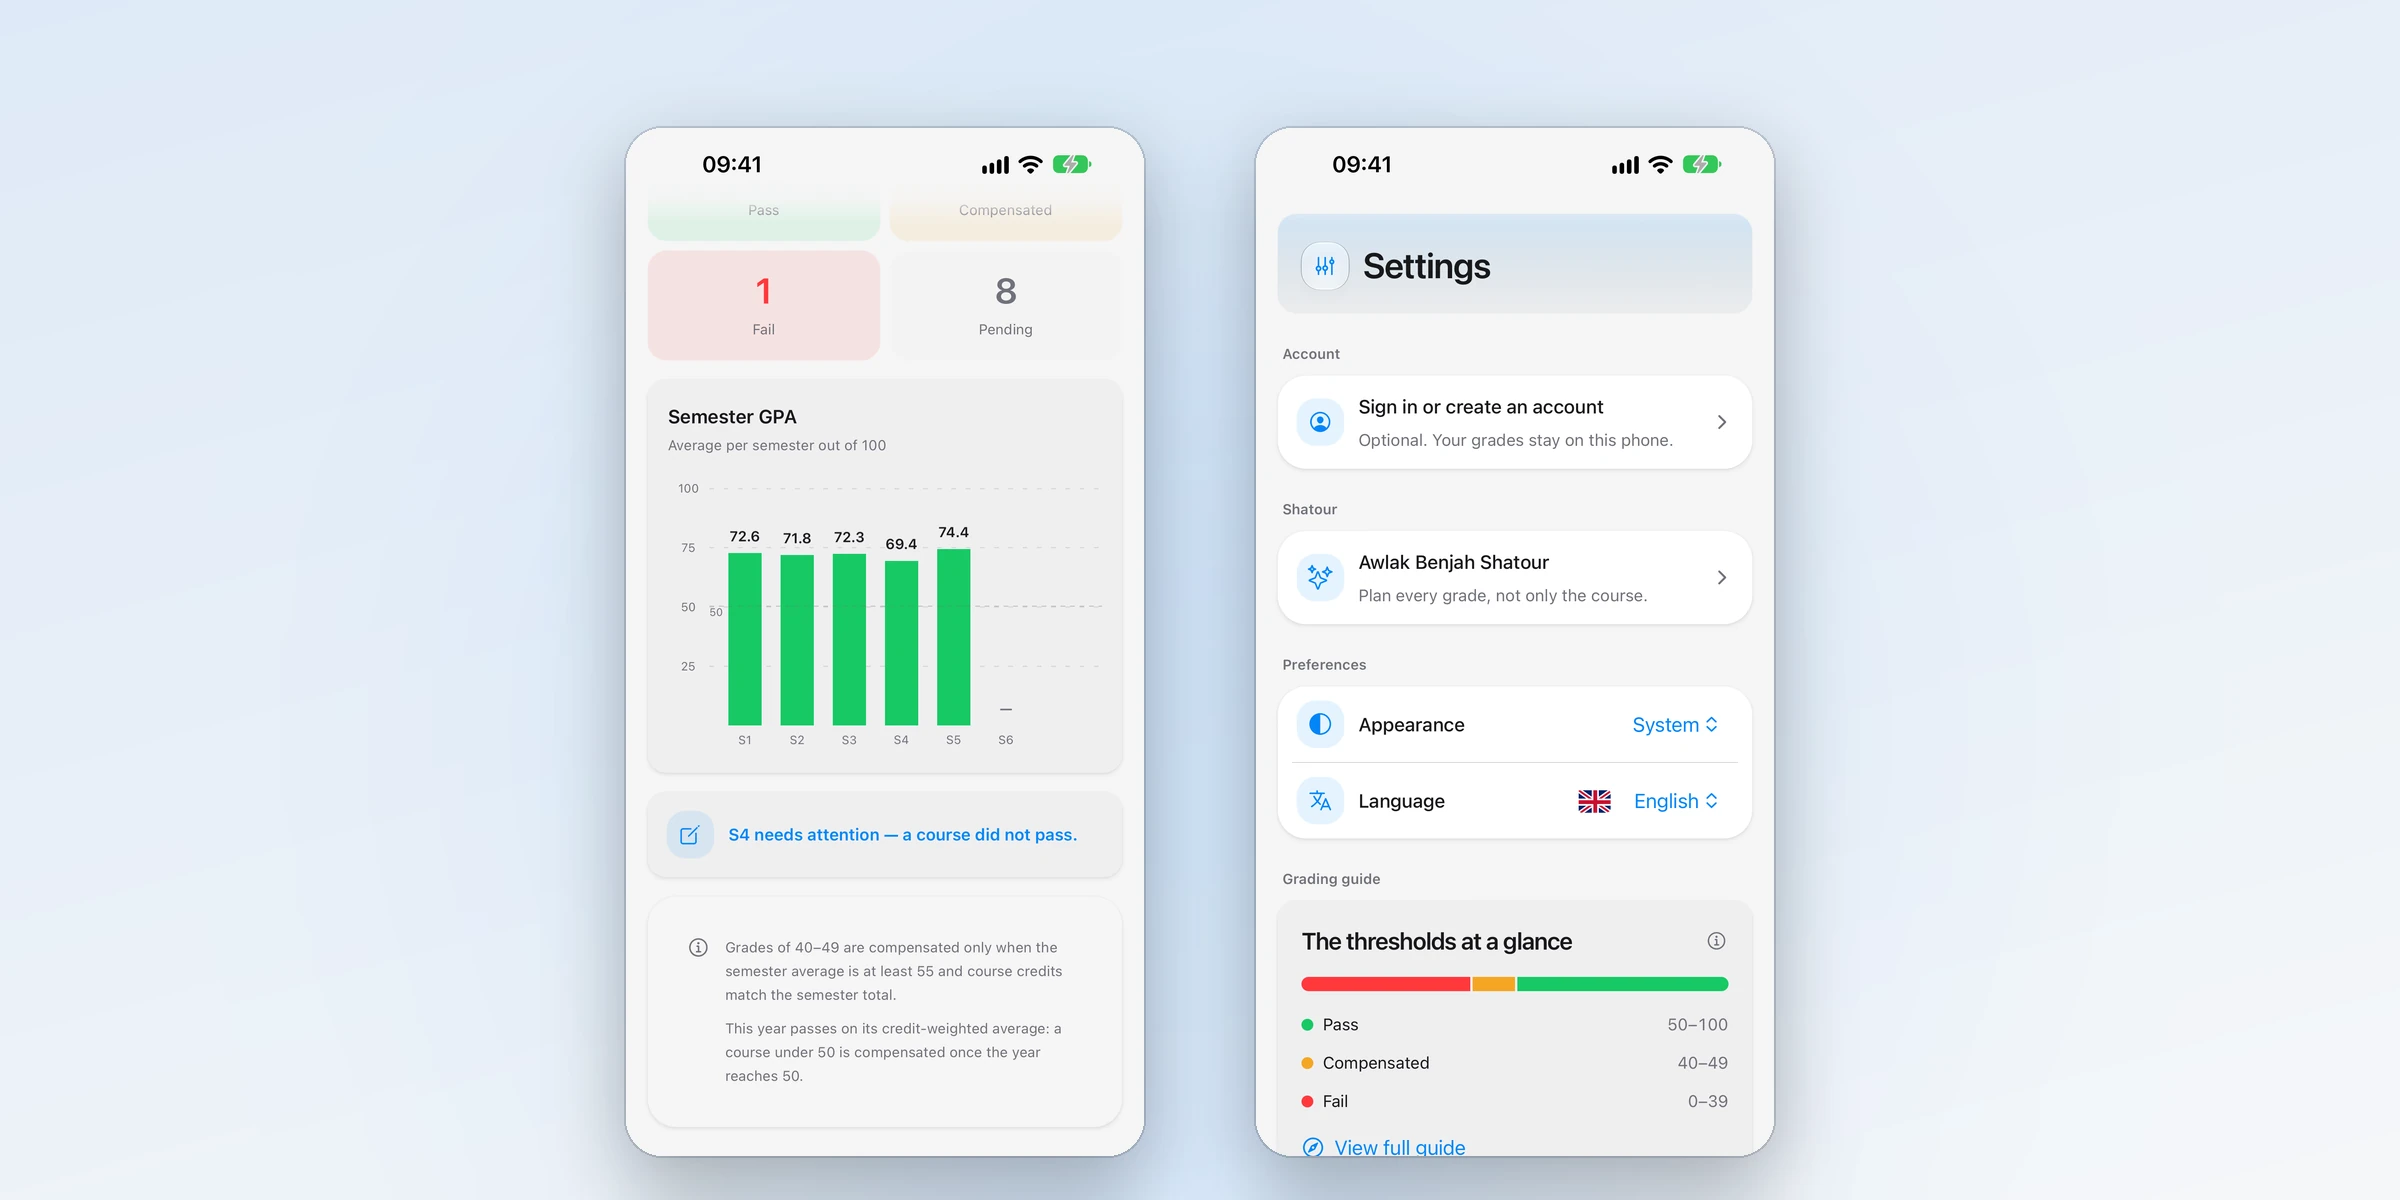
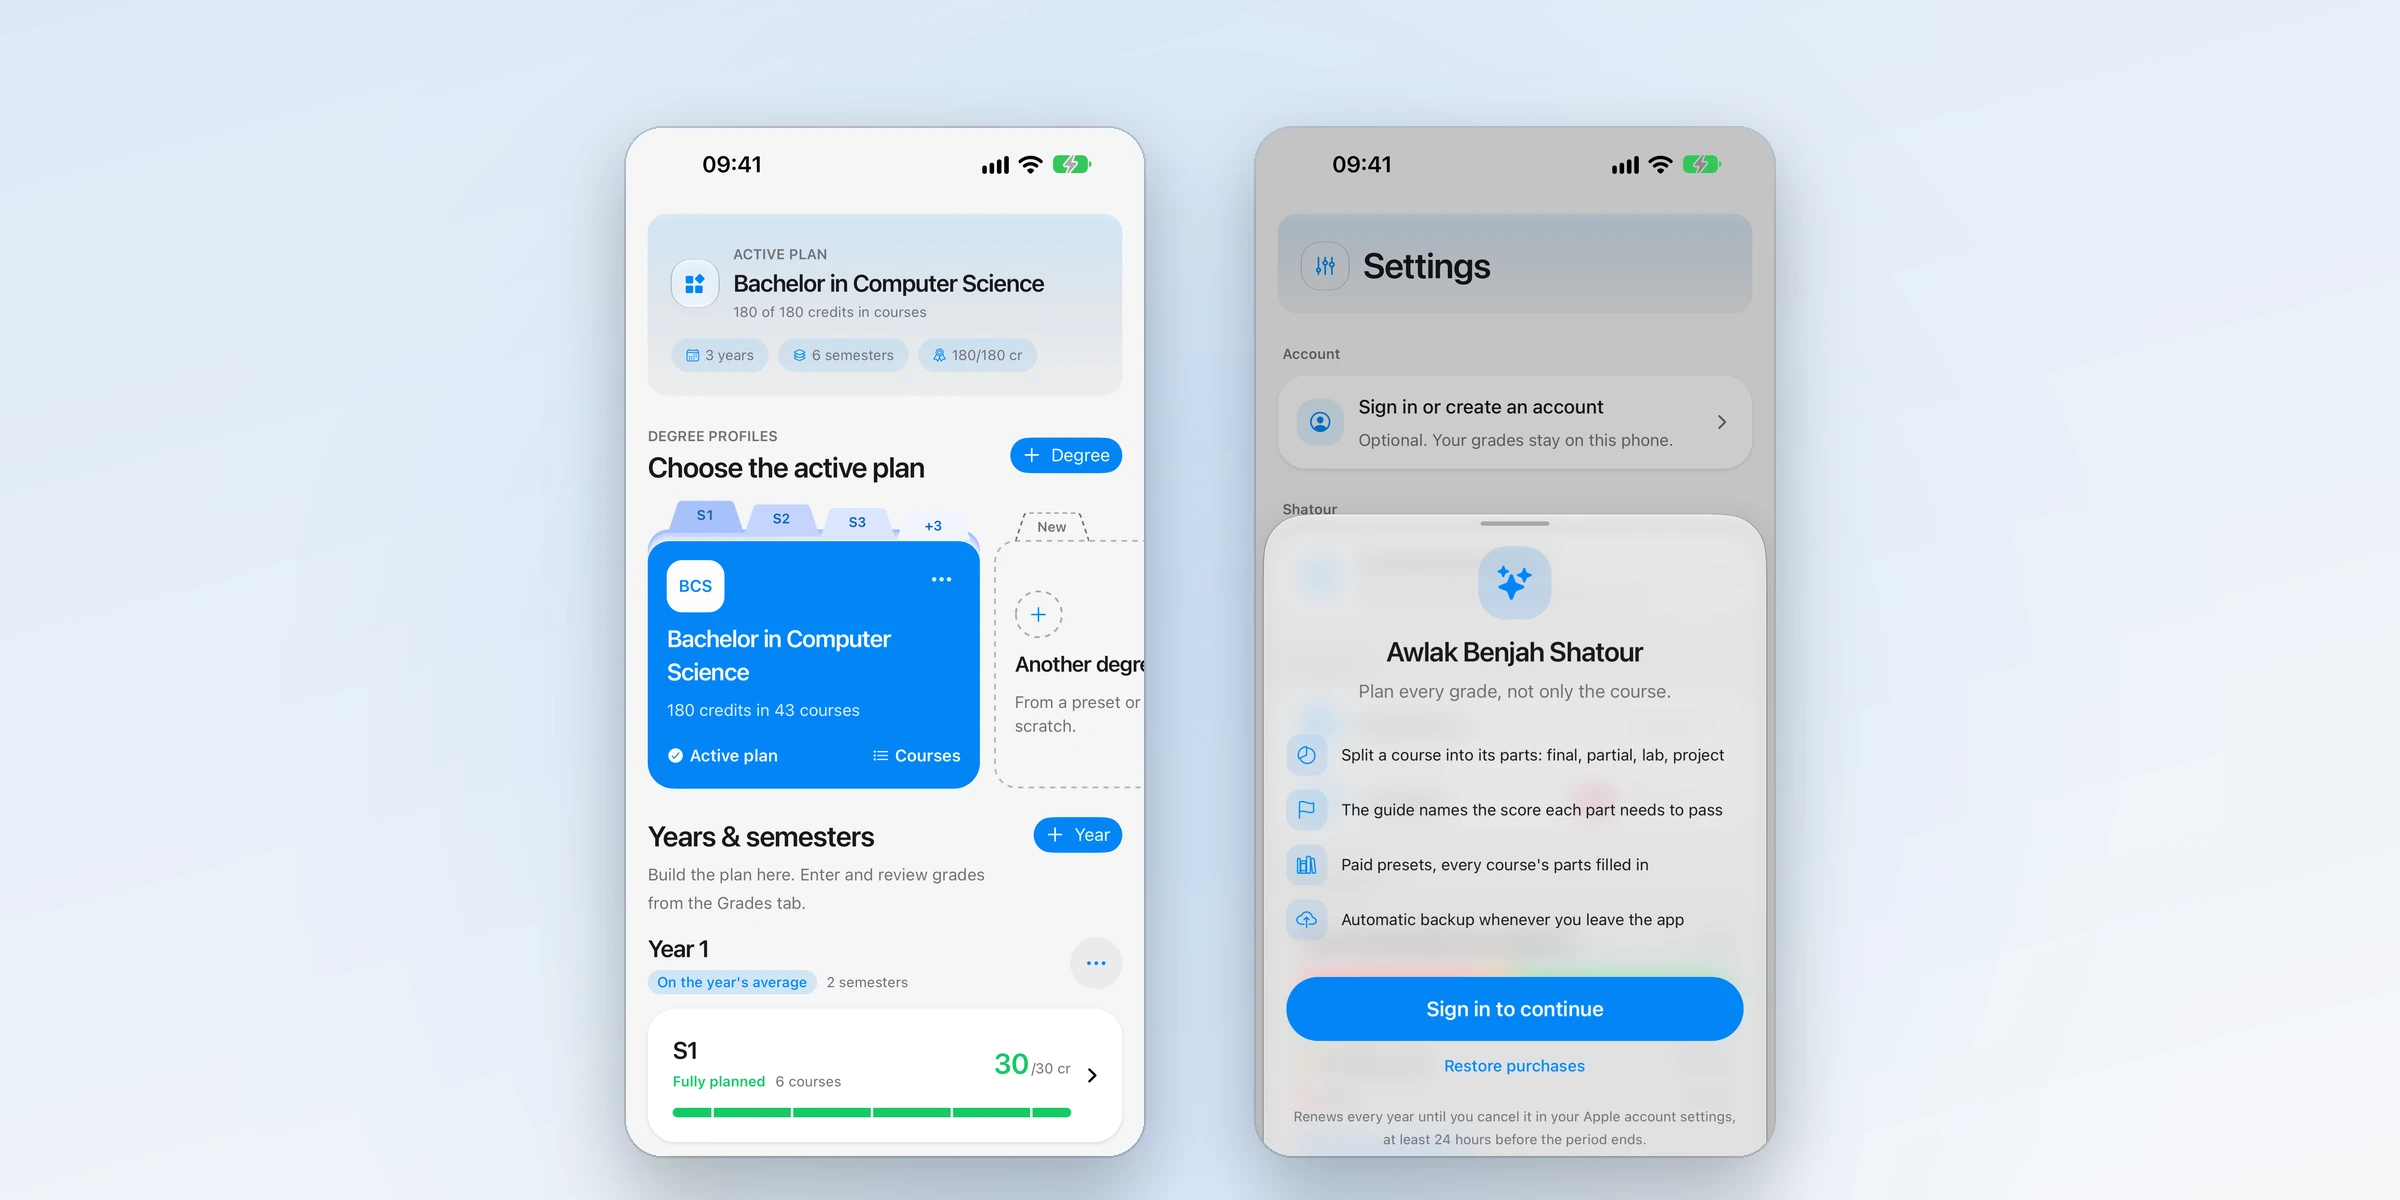
Awlak Benjah? (« est-ce que je vais réussir ? » en libanais) est un outil de suivi de diplôme et de moyenne pour les étudiants de l'Université libanaise. L'application modélise un diplôme en années, semestres, cours et notes sur 100, et calcule sur l'appareil les moyennes pondérées par les crédits, la compensation et le verdict de réussite ou d'échec de chaque année, sans aller-retour réseau et sans compte.
La difficulté, c'est que les règles de réussite ne tiennent pas en une formule. Une année peut être jugée semestre par semestre, où un cours est validé à 50 et une note de 40 à 49 est compensée quand le semestre atteint 55 de moyenne avec tous ses crédits, ou sur la moyenne de l'année pondérée par les crédits, et un même diplôme peut mêler les deux. Chaque règle est une stratégie dans un paquet de notation partagé, avec un juge, un plan qui alimente le guide de réussite, un verdict « inconnu » explicite, et un seul test d'invariants exécuté sur chaque règle, si bien que l'application, la démo web et les tests ne peuvent pas diverger.
Autour de ce cœur hors ligne vient un backend facultatif. Une API NestJS sert les modèles de diplôme, conserve les comptes et les sauvegardes, et décide de l'accès Premium (« Shatour » pour les étudiants) à partir d'un droit d'accès qu'écrit le webhook de RevenueCat. Chaque route est déclarée une seule fois comme contrat oRPC et consommée via un client typé par l'application comme par la console web, où se gèrent utilisateurs, abonnements et versions, à côté d'un chat IA qui lit les comptes et le journal d'audit via des outils MCP.
Dans l'application
L'application fonctionne d'abord en local : elle porte donc la logique métier qu'un backend porterait d'ordinaire. Son code est découpé en couches dont les imports ne vont que vers le bas, et ces règles sont vérifiées par dependency-cruiser à chaque contrôle, pas laissées à la relecture.
- Quatorze modules, une carte des dépendances. Chaque module (diplômes, années,
semestres, cours, notes, rapports, compte, sauvegarde et les autres) expose un
index.tspour les écrans et unmodel.tspour son modèle sans framework, et ne peut importer que les modules listés pour lui. Un enfant connaît ses ancêtres, jamais l'inverse : ajouter une dépendance est une décision de relecture, pas une commodité. - Un MVVM qui a du mordant. Les Views affichent, les hooks ViewModel portent la logique.
Un script fait échouer le contrôle à la moindre logique de calcul dans une View (
.filter(,Math., unuseStateinitialisé depuis une prop), et le lint interdit dans les fichiers de View les hooks qui portent de la logique, commeuseEffectetuseMemo. - Une unité de travail par cas d'usage. Un cas d'usage valide son entrée, s'exécute dans une seule transaction SQLite et renvoie des erreurs typées que les écrans traduisent en messages.
- Le React Compiler est activé, donc ses règles de lint sont des erreurs : un composant qui en enfreint une perdrait son optimisation sans bruit.
Une flèche désigne un module que l'autre peut importer (une partie de la carte des dépendances). Les modules de composition, comme les rapports, setup et settings, sont en amont, et aucun module fonctionnel ne les importe.
Un backend fondé sur les contrats
L'API, la console et l'application partagent une seule source de vérité pour chaque route.
- NestJS 12 avec Drizzle sur PostgreSQL, des sessions lues dans Redis, better-auth pour
les codes par e-mail, la connexion Apple et Google et la vérification en deux étapes des
administrateurs, et chaque erreur renvoyée sous la forme
{ code, message }, pour que les clients traduisent le code au lieu d'afficher le message anglais. - Des routes versionnées sous
/v1. Les applications installées continuent d'appeler ce avec quoi elles ont été publiées : un changement cassant est donc une nouvelle version, et la CI refuse celui qui n'est pas étiqueté comme tel. - La confidentialité est un contrat de publication. L'application n'envoie rien sur un étudiant tant qu'il ne crée pas de compte, et tout changement qui fait sortir des données de l'appareil met à jour la politique de confidentialité dans la même pull request.
- La console (Vite, React, TanStack Router et Table) gère utilisateurs, abonnements, modèles, versions, logs, crashs et déploiements depuis un seul endroit, en rapatriant les données de Sentry et de RevenueCat plutôt que d'y renvoyer. Son chat IA lit via des outils MCP et rédige les notes de version et les textes des stores, et chaque écriture attend l'approbation d'un administrateur.
CI/CD
Chaque changement, aussi petit soit-il, suit le même chemin : une issue GitHub, une branche,
une pull request fusionnée en squash, la préproduction, puis une version qui part en
production. Rien n'est poussé directement sur main.
De l'issue à la production
La vie d'une pull request
Ce que lance la CI
- Seul ce qui a changé est contrôlé. Un job
Changesdemande à Turborepo quels paquets une pull request touche, y compris tout ce qui en dépend, et le job de chaque application ne s'exécute que si elle est concernée. Un paquet partagé fait donc recontrôler chaque application qui l'utilise. - Les contrôles d'une application sont les étapes d'un seul job (lint, règles de dépendances, typage, tests, build), car GitHub facture chaque job à la minute entamée. Ce choix a divisé la facture par deux par rapport à un job par contrôle. Chaque contrôle rend quand même son verdict si un précédent échoue, tandis que le build ne s'exécute que si tous les contrôles sont passés.
- Un cache, deux endroits. Le cache distant de Turborepo est partagé par la CI et le contrôle local : une tâche dont les entrées sont déjà passées quelque part est rejouée en une seconde au lieu d'être relancée. Prettier garde aussi un cache par contenu.
- La CI ne tourne que sur les pull requests.
mainn'avance que par des fusions en squash, et recontrôler chaque fusion coûtait plus de la moitié des minutes du plan gratuit. - Le contrôle des contrats régénère le document OpenAPI, le compare à celui de
mainet fait échouer une pull request qui casse/v1, sauf si elle est étiquetée comme une rupture voulue. - Un travail récent a fait passer une pull request API typique d'environ 8,5 à 4,5 minutes. L'image Docker se construit à côté des contrôles plutôt qu'après, et les 431 tests de l'API sont passés de 146 à 49 secondes en donnant à vitest un worker par cœur et en important l'application une fois par worker plutôt qu'une fois par fichier de test.
La mise en production
- La préproduction suit
main: chaque fusion déploie les applications qu'elle touche, l'API d'abord, puisque le nouveau code web peut appeler de nouvelles routes. - La production est une version. release-please garde une pull request de version ouverte, avec la prochaine version et le changelog déduits des titres fusionnés. La fusionner crée le tag, déploie la production et construit l'application iOS sur EAS pour TestFlight quand l'application a changé.
- L'API part en conteneur, sans registre : l'image est envoyée au serveur par SSH avec une clé qui ne peut lancer que le script de déploiement. Les migrations s'exécutent avant le remplacement, si bien qu'une migration ratée laisse l'ancien conteneur en service, et un health check en échec remet l'image précédente.
- Autour de la chaîne : Renovate ne propose que les mises à jour cochées sur son tableau de
bord,
pnpm auditetexpo-doctortournent chaque semaine, et les deux bases de données sont sauvegardées chaque nuit vers Cloudflare R2.
Construit avec des agents IA
L'essentiel du code a été écrit avec Claude Code, selon les mêmes règles qu'un contributeur humain suivrait.
- Chaque tâche est une issue GitHub, étiquetée et placée sur le tableau du projet, avec la
consigne et les preuves de validation consignées en commentaires. Deux skills écrits pour ce
dépôt,
github-issuesetship-changes, portent le processus de l'issue à la production. - 28 skills d'agents vendorisés, épinglés par empreinte dans un fichier de verrouillage et
relus comme du code :
expo-uid'Expo, les bonnes pratiques React Native etagent-devicede Callstack pour piloter les simulateurs, les skills de contrats d'oRPC, Uniwind, les guides de sécurité de Better Auth, les skills d'animation et de design d'Emil Kowalski, etgoldiepour les captures des stores. Les bibliothèques qui livrent leurs propres skills, comme drizzle-kit et TanStack Router, sont liées par pnpm à la version installée. - Des garde-fous plutôt que la confiance. Un
AGENTS.mdpar application regroupe les conventions, un hook passe le lint sur chaque fichier qu'un agent modifie et lui renvoie les erreurs, et les règles d'architecture, le contrôle des Views et celui des contrats arrêtent un mauvais changement, quel qu'en soit l'auteur. - Des serveurs MCP pour la documentation de Better Auth, Sentry et drizzle-kit donnent aux agents le même contexte qu'un développeur irait chercher.
Fonctionnalités clés :
- Modèle de données hors ligne sur
expo-sqlitevia Drizzle ORM, avec import d'un modèle en une seule transaction - Règles de réussite (
credit-based,year-average) sous forme de stratégies dans@awlak-benjah/grading, partagées par l'application, la démo web et les tests - Un guide de réussite pour chaque cours ouvert, et avec Shatour la note dont chaque partie a besoin
- Modèles de diplôme servis par l'API : les gratuits ouverts à tous, les payants verrouillés derrière l'écran d'abonnement
- Un compte gratuit pour la sauvegarde et la restauration manuelles ; Shatour ajoute la sauvegarde automatique et le découpage des cours
- Achats intégrés via RevenueCat, annuel et à vie, accordés comme droit d'accès sur le compte
- Anglais, français et arabe, de droite à gauche en arabe, modes clair et sombre, et un widget d'écran d'accueil
- Contrôles iOS natifs via
@expo/ui, avec des mises en page React Native et une interface Liquid Glass - Une console web pour les utilisateurs, les abonnements et les modèles, où l'IA de la console rédige les textes des stores en trois langues
Stack technique :
- Mobile : Expo SDK 58, React Native, Expo Router, @expo/ui, Uniwind, Reanimated, expo-widgets
- Données : expo-sqlite, Drizzle ORM, Zustand, TanStack Query, Zod
- API : NestJS 12, oRPC, better-auth, PostgreSQL, Redis, Resend, Vercel AI SDK
- Web : Vite, React, TanStack Router, TanStack Table
- Paiements et exploitation : RevenueCat, Sentry, Cloudflare Workers, Docker sur un VPS derrière Caddy, sauvegardes nocturnes de la base vers R2
- Outillage : Turborepo, pnpm, TypeScript, oxlint, dependency-cruiser, Vitest, knip, release-please, Renovate
En chiffres (novembre 2026) : 603 commits depuis juillet 2026, 232 pull requests fusionnées, 13 versions, environ 1 300 tests (342 dans l'application, 178 dans le paquet de notation, 431 dans l'API, 197 dans la console et 159 dans la vitrine) et 17 workflows GitHub Actions.
Le dépôt est privé. L'application arrive sur iOS et Android, et sa vitrine se trouve sur awlak-benjah.com.